AI 반도체 시장의 독주자 엔비디아의 가장 무서운 무기는 단순한 하드웨어 성능이 아닙니다. 지난 수십 년간 엔비디아가 쌓아 올린 독점적 소프트웨어 플랫폼 쿠다(CUDA) 생태계야말로 여타 빅테크 기업들이 넘기 힘든 거대한 벽이었습니다. 하지만 클라우드 시장의 절대강자 아마존이 이 거대한 ‘소프트웨어 해자’를 정면으로 돌파할 강력한 우회로를 제안했습니다.
바로 파이토치 기반 AI 코드를 복잡한 재작성 없이 자사의 자체 AI 칩 ‘트레이니엄’에서 그대로 실행하게 해주는 오픈소스 도구 ‘토치뉴런(TorchNeuron)’을 공식 발표한 것입니다. 이번 포스트에서는 토치뉴런이 무엇인지, 엔비디아 CUDA(쿠다) 가 왜 그토록 강력했는지, 그리고 투자자가 무엇을 확인해야 하는지에 대해 알아보도록 하겠습니다.
토치뉴런이란? 한 줄 요약
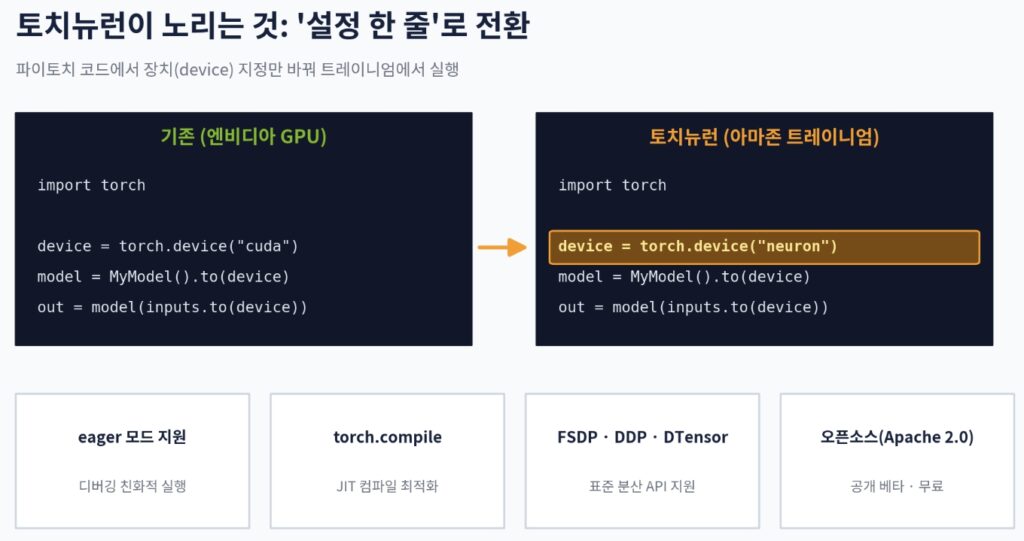
토치뉴런은 아마존이 내놓은 오픈소스 도구로, 파이토치 코드를 최소한의 변경만으로 트레이니엄 칩에서 실행하게 해줍니다. 아마존의 칩 설계 부문인 애너푸르나 랩스는 설정 하나만 바꾸면 같은 코드를 자체 칩에서 돌릴 수 있다고 설명합니다. 기술 문서를 보면 구조가 더 선명해집니다.
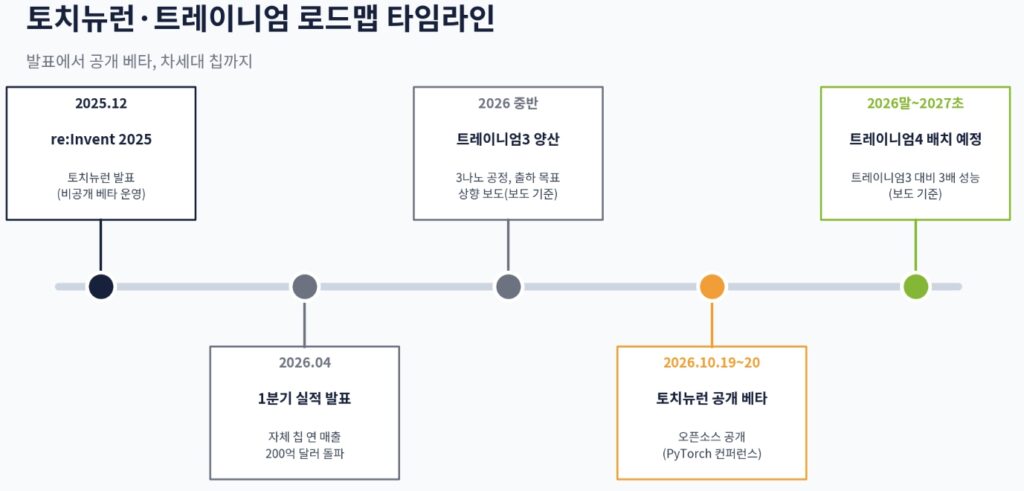
기존 파이토치 코드에서 텐서의 장치 지정을 cuda에서 neuron으로 바꾸는 것이 핵심이며, eager 모드, torch.compile, FSDP·DDP 같은 표준 분산 API도 지원합니다. 참고로 토치뉴런이 완전히 새로운 것은 아닙니다. 비공개 베타로 운영되던 이 소프트웨어를 아마존이 이번에 모든 개발자에게 공개 베타로 연 것입니다. 즉 이번 뉴스의 핵심은 기술의 탄생이 아니라 ‘문턱의 개방’이라고 할 수 있습니다.
엔비디아 독주의 핵심 CUDA란 무엇인가
1) CUDA의 개념
CUDA(Compute Unified Device Architecture) 는 엔비디아 GPU를 그래픽 처리뿐 아니라 일반적인 연산에도 쓸 수 있게 만든 병렬 컴퓨팅 플랫폼입니다. 2000년대 중반 처음 등장했을 때 개발자들은 C와 C++ 같은 익숙한 언어로 엔비디아 GPU를 프로그래밍할 수 있게 되었습니다. 쉽게 비유하면, GPU는 수천 개의 일꾼이 달린 공장이고 CUDA는 그 일꾼들에게 일을 나눠주는 작업 지시서이자 통역 시스템입니다. 공장(칩)이 아무리 좋아도 지시서(소프트웨어)가 없으면 가동할 수 없습니다. 그리고 이 지시서는 엔비디아 칩에서만 읽힙니다.
2) 개발자들이 CUDA를 쓸 수밖에 없었던 4가지 이유
한 마디로 정의하면 엔비디아는 칩이 아니라 ‘습관과 인프라’를 팔아 왔고, 이것이 높은 마진의 근거로 지금까지 해석되어 왔습니다.
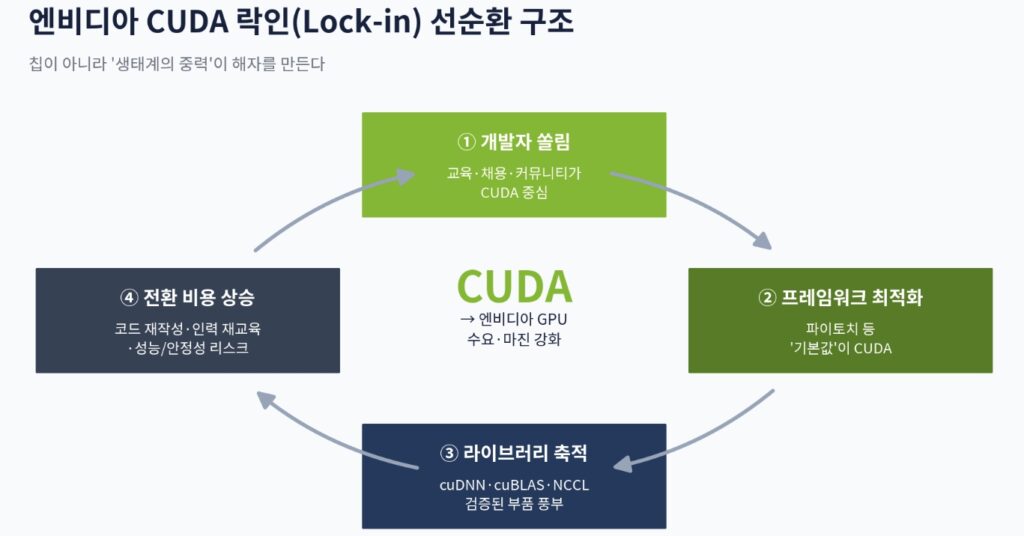
- 20년 가까이 쌓인 라이브러리 생태계: CUDA는 NCCL, cuDNN, cuBLAS 등과 함께 주요 머신러닝 프레임워크에 깊숙이 내장된 소프트웨어 플랫폼을 이룹니다. 딥러닝 연산, 행렬 계산, 멀티 GPU 통신까지 이미 검증된 부품이 갖춰져 있으니 개발자는 바퀴를 다시 만들 필요가 없습니다.
- 프레임워크의 기본값이 CUDA: 프레임워크가 CUDA에 최적화되어 개발자가 엔비디아를 쓰고, 개발자가 엔비디아에 몰리니 프레임워크도 CUDA에 머무르는 순환 구조가 만들어졌습니다. 파이토치 코드에서 장치를 ‘cuda’로 지정하는 한 줄이 전 세계 수많은 코드베이스에 박혀 있다는 뜻입니다.
- 사람과 교육의 쏠림: AI 연구자는 CUDA를 배우고, 기업의 AI 배치는 CUDA를 전제로 합니다. 엔비디아 생태계에는 약 400만 명의 개발자와 4만 개 기업이 속해 있다는 추정도 있습니다(업계 추정치이므로 참고용입니다). 채용, 대학 교육, 커뮤니티 질의응답까지 모두 CUDA 중심이니 팀이 다른 길을 택하기 어렵습니다.
- 높은 전환 비용: AMD ROCm으로 옮기는 개발자는 CUDA 커널을 HIP으로 다시 쓰고, cuDNN 호출을 MIOpen으로 바꾸며, 이미 해결된 문제들을 공유하던 커뮤니티를 잃게 됩니다. 칩 가격이 저렴해도 이식 비용과 위험이 절감분을 갉아먹기 쉬웠습니다. 관련 업계에서는 이를 두고 “생태계의 중력”이라고도 표현했습니다.
토치뉴런의 승부수: 전환 비용을 겨냥하다
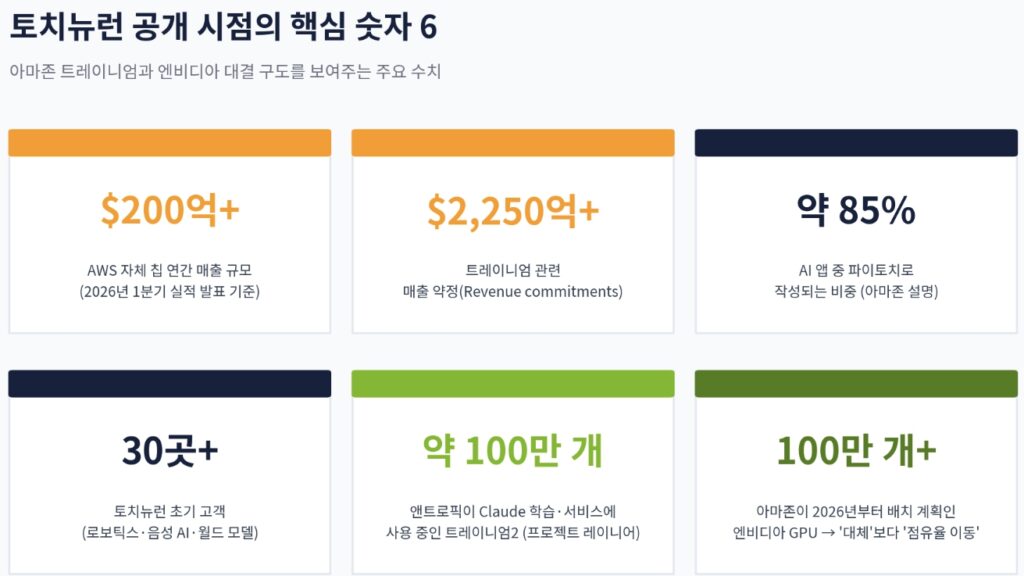
아마존의 논리는 단순합니다. 아마존은 AI 앱의 약 85%가 파이토치로 작성된다고 설명하며, 엔비디아 이식에 수개월의 엔지니어링이 필요할 수 있다는 점을 지적했습니다. 대다수가 같은 프레임워크 위에 있다면, 그 프레임워크 레벨에서 칩 교체를 쉽게 만들면 됩니다. 애너푸르나 랩스의 콜린 브레이스 부사장은 “파이토치를 안다면 트레이니엄도 안다”는 취지로 설명했습니다.
실적도 일부 있습니다. 앤트로픽이 아마존의 ‘프로젝트 레이니어’ 클러스터에서 트레이니엄을 이미 쓰고 있고, 로보틱스·음성 AI·월드 모델 분야 30개 이상의 초기 고객이 토치뉴런을 사용 중입니다. 아마존은 일부 고객이 트레이니엄 전환 후 상당한 비용 절감을 보고했다고 밝혔습니다.
시장 관점에서 본 의미와 투자 포인트
1) 아마존(AMZN)에게는 ‘수요 깔때기’ 확대입니다.
아마존은 올해 1분기 실적 발표에서 자체 칩 사업의 연간 매출 규모가 200억 달러를 넘었고 트레이니엄 관련 매출 약정이 2,250억 달러 이상이라고 밝혔습니다. 약정이 많아도 이를 실제 사용량으로 바꾸려면 개발자가 쉽게 올라타야 합니다. 토치뉴런은 그 입구를 넓히는 장치입니다. 또한 3나노 공정의 트레이니엄3가 양산에 들어갔고, 트레이니엄4는 2026년 말~2027년 초 초기 배치가 예정되어 있다는 보도도 있습니다.
2) 엔비디아(NVDA)에게는 ‘해자 축소’ 신호이지만 단기 위협은 제한적입니다.
아마존도 2026년부터 100만 개 이상의 엔비디아 GPU 배치를 계획하고 있어, 대체라기보다 점유율 이동에 가깝다는 해석이 우세합니다. 게다가 트레이니엄4는 엔비디아 NVLink Fusion을 지원해 GPU와 트레이니엄을 한 클러스터에서 섞어 쓰는 구성이 가능하다고 알려져 있습니다. 경쟁과 공존이 동시에 진행되는 셈입니다.
3) 고객(AI 기업)에게는 협상력 상승입니다.
대체재가 현실적이 되면 AI 인프라 가격 협상에서 선택지가 늘어납니다. 이는 AI 설비투자 부담에 민감한 시장 분위기에서 의미가 큽니다.
그래도 확인해야 할 한계와 리스크
- 성능·경제성 검증 부족: CUDA는 여전히 성숙한 생태계이며, 아마존은 까다로운 워크로드에서 트레이니엄의 성능·신뢰성·경제성을 입증해야 합니다. 한 분석은 2026년 7월 기준 트레이니엄과 엔비디아의 토큰당 비용을 직접 비교한 공개 벤치마크가 없다고 지적했습니다.
- ‘설정 한 줄’의 범위: 표준 파이토치 경로에서는 쉬울 수 있지만, 맞춤형 CUDA 커널이나 특수 연산이 많은 워크로드는 이식이 훨씬 까다롭습니다.
- 통신·툴체인 의존: 앞서 본 NCCL, 프로파일링과 디버깅 습관 같은 부분은 프레임워크 레벨 호환만으로 대체되지 않습니다.
- 아마존 종속 가능성: 트레이니엄은 AWS 안에서만 쓰는 칩이므로, CUDA 종속을 AWS 종속으로 바꾸는 것은 아닌지도 점검할 부분입니다.
지금까지 아마존의 토치뉴런 공개와 AI 생태계에 가져올 변화에 대해 알아보았습니다. 토치뉴런이 오랜 기간 다져진 엔비디아의 CUDA 생태를 무너뜨리는 도구는 아닙니다. 복잡한 커스텀 CUDA 연산자를 사용하는 극한의 최적화 작업이나 특수 연산 환경에서는 여전히 엔비디아 GPU가 우위를 점할 가능성이 높습니다. 다만 ‘CUDA를 쓸 수밖에 없다’는 전제를 ‘CUDA를 쓸 필요는 없을 수도 있다’로 바꾸려는 시도라는 점에서 상징성이 큽니다. 해자는 보통 한 번에 무너지지 않고, 전환 비용이 조금씩 낮아질 때 서서히 좁혀지기 때문입니다.
앞으로 소프트웨어 장벽을 깨부수려는 빅테크 기업들의 경쟁 속에서 AI 인프라 시장의 주도권 다툼은 더욱 치열해질 것으로 전망입니다. 아마존과 엔비디아 투자에 관심이 있거나 이미 투자하신 분들은 성능 검증과 채택 속도라는 두 가지 지표를 지속적으로 모니터링 하시기 바랍니다.
“상기 내용은 투자 권유나 종목 추천이 아닌 단순 정보 제공을 위한 용도입니다.
투자 시 책임은 투자자 개인에게 있으며 투자 시 충분한 분석과 신중한 판단을 하시기 바랍니다.”